Sound Signal Processing Library for Spresense を使うためのメモ
目次
Spresenseの音源再生用ライブラリ、Sound Signal Processing Library for Spresenseを使うためのメモ。
チュートリアルがあるので、使い方はわかるが、再生する音源ファイルの作成方法が、ちゃんとしたDAWをもっていないので、わからなかった。
ということで、サンプル音源(assets.zip)だけではなく、オリジナル音源を作成するための便利なプログラムをメモしておく。
その1 音源ファイル形式変換
./tools/README.md に
ssprocLibが提供しているSFZSinkモジュールには、いくつかの制約があります。
...
音源サンプルファイルの制約
ファイル形式はWAVファイルであること。
サンプリング周波数は48kHz、ビット幅は16bit、チャンネル数は2であること。
この制限は、MacでGarageBandを利用していると、ちょっとめんどい。 GarageBand のFile保存を利用して、.wavを作成すると、選択の余地なく、サンプリング周波数がCDの44.1kHzになってしまう。
また、ちょっといい音源を購入すると、ビット幅が24bitsだったりする。
プログラム
pythonのプログラムで、.wavの形式をSound Signal Processing Library for Spresense用にビシッと形式変換する。
起動方法
例えば、プログラム名を convert16bitswav.py 、変換元のディレクトリを in 、変換後のディレクトリを out とした場合、こんな感じで実行する。
python3 convert16bitswav.py in out想定するディレクトリ構成は、これ。
convert16bitswav.py
in/
└── nya-ngruuu.wav
out/
└── nya-ngruuu.wav ... 16bits 48kHz
必要なpackage
ffmepg とか面倒くさいので、入れたくない。 以下のpip packageのみでOK。
pip install soundfile numpysource code
import os
import sys
import wave
import numpy as np
import soundfile as sf

args = sys.argv
if len(args) != 3:
    print("Usage: {} in_dir out_dir\n".format(args[0]))
    sys.exit(1)

in_dir = args[1]
out_dir = args[2]

# format for Sound Signal Processing Library for Spresense
to_rate = 48000
to_subtype = "PCM_16"
to_channels = 2

for filename in os.listdir(in_dir):
    if filename.endswith(".wav"):
        wav_path = os.path.join(in_dir, filename)
        print("formatting: ", wav_path)
        base_name = os.path.splitext(filename)[0]
        formated_dir = os.path.join(out_dir, base_name + ".wav")
        data, rate = sf.read(wav_path)

        to_data = (data * np.iinfo(np.int16).max).astype(np.int16)

        sf.write(formated_dir, to_data, to_rate, format="WAV", subtype=to_subtype)
サンプル音源
44.1kHz
48kHz
その2 音量UP
オリジナル音源だと、音量が小さいことがある。
1個くらいならDAW上で手動調整でもいいけど、たくさんあると面倒なので、これもプログラムでなんとかする。
プログラム
ffmpegの実行環境が必要。 dockerでpythonの最新版を起動(きっとubuntu)しておくか、mac nativeがよさそう。
setup
for ubuntu
apt-get update -y
apt-get install ffmpeg -y
pip install AudioSegment
起動方法
例えば、プログラム名を volume_up.py 、factor を 10 倍、変換元のファイルを x.wav 、変換後のファイルを x2.wav とした場合、こんな感じで実行する。
python3 volume_up.py 10 x.wav x2.wav音量UPのfactorは、変換後の音源を再生して、耳で聞いて調整する。 最終的に80dBくらいが楽器としてはちょうどいいかも。
source code
変換元の音源ファイルを読み込むときに、AudioSegment.from_mp3(in_file) との記述があるが、 .wav でも問題なし。
from pydub import AudioSegment
import sys

args = sys.argv
if len(args) != 4:
    print("Usage: {} factor(1-255) in_file out_file\n".format(args[0]))
    sys.exit(1)

in_file = args[2]
out_file = args[3]
factor = int(args[1])

Audio = AudioSegment.from_mp3(in_file)
newAudio = Audio + factor
newAudio.export(out_file, format="wav")
waveform
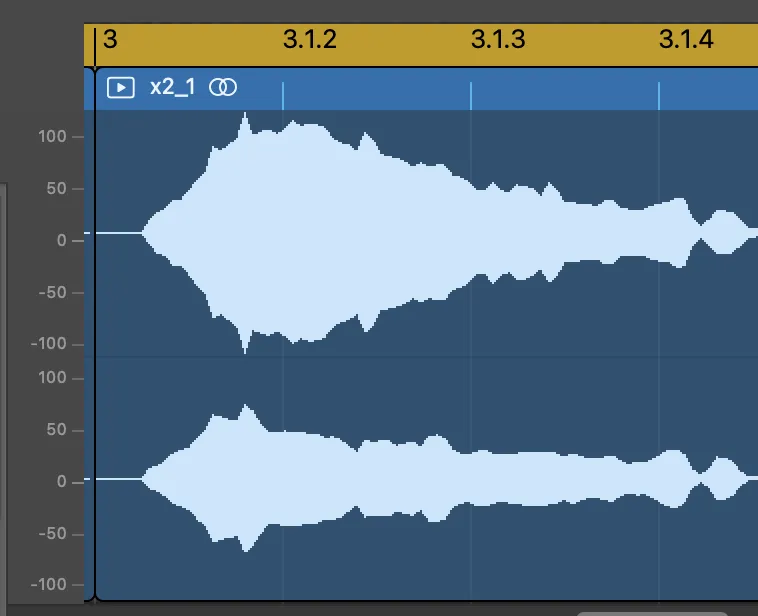
Garage Band waveform を比較するとこんな感じ。
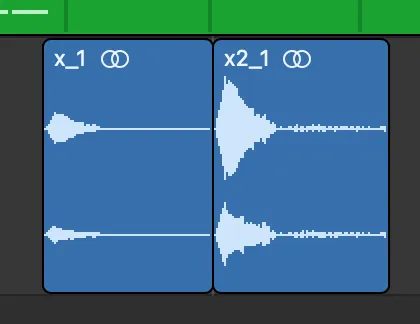
元々最大50dBだったものが、110dBくらいになった。
ちょっと大きすぎたかも。